Llama – L'IA locale de llama.cpp, sans ligne de commande

Faire tourner un modèle de langage en local sur son PC, avec llama.cpp, ça marche très bien, mais ça demande quand même de mettre un peu les mains dans le cambouis. Il faut aller chercher le binaire, trouver
le bon fichier GGUF sur Hugging Face
et lancer le serveur en ligne de commande.
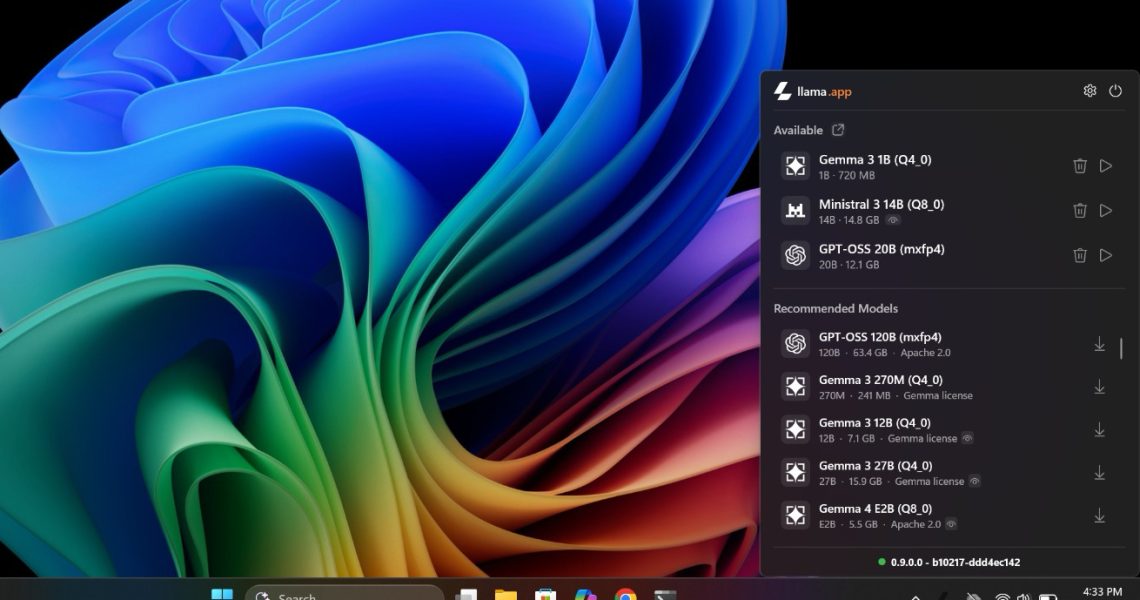
Heureusement, léquipe de ggml-org, celle qui développe justement llama.cpp, souhaite soulager notre peine en nous proposant pour Windows 11 une petite app baptisée Llama (Ouais, c’est original comme nom ^^) qui se loge dans la zone de notification et qui fait tout le taf à votre place.
C’est en fait un portage pour Windows de
, qui est lui aussi dans la barre des menus de macOS. Côté install, suffit de récupérer le fichier .msixbundle dans les Releases du dépôt, vous double-cliquez dessus, et c’est parti mon kiki. Si vous avez déjà un llama.exe sur votre machine, l’app s’en servira, sinon elle en téléchargera un toute seule. Et bien sûr, le code est sous licence MIT, avec un petit copyright au nom de Hugging Face quand même.
Une fois que c’est en place, l’icône ouvre un petit panneau de commande avec une liste de modèles recommandés à télécharger en un clic. Vous pouvez aussi chercher n’importe quel modèle GGUF du Hub directement depuis cette liste, ou coller l’identifiant d’un dépôt. L’app vérifie également au passage s’il vous reste assez de place sur le disque avant de lancer le téléchargement ! (Moi j’ai 4 To et je suis toujours PLEIN, j’en ai marre ^^)

Bref… en cliquant sur un modèle, vous choisissez sa taille de contexte, et pour chaque option, l’app vous donne une estimation de la mémoire consommée, qu’elle récupère dans l’en-tête du fichier GGUF. C’est très pratique pour savoir avant de le lancer si ça va tenir dans votre fichue machine. Et comme les modèles sont stockés dans le cache standard de Hugging Face, bah ils sont partagés avec llama.cpp et les autres outils qui l’utilisent, ce qui évite d’avoir des doublons de plusieurs gigas sur le disque.
Mais le truc le plus sympa, je crois c’est le raccourci Alt+Espace qui, peu importe ce que vous êtes en train de faire, ouvre une fenêtre avec l’interface web du chat IA près à vous répondre, un peu à la manière de Spotlight sur Mac. Et quand vous la refermez, hé bien elle se planque simplement au lieu de se fermer ce qui fait qu’elle se réaffiche instantanément avec votre conversation dès que vous en avez besoin.

Par contre, dommage, ce raccourci est codé en dur et il n’y a aucun réglage pour en changer. Donc si une autre app squatte déjà Alt+Espace, comme PowerToys Run dont c’est le raccourci par défaut, hé bien Llama vous prévient mais ça n’ira pas plus loin. A moins que vous changiez le raccourci par défaut de
.
Côté vie privée, Llama n’envoie aucune data de télémétrie et vos prompts restent sur votre machine. Et comme l’app pilote un serveur llama.cpp qui expose une API REST, la fiche d’un modèle vous proposera même une requête curl toute prête afin de brancher vos autres outils dessus.
Attention si
est activé sur votre PC, il se peut que Windows bloque llama.exe, qui n’est pas signé (contrairement au paquet MSIX de l’app). Dans ce cas, le serveur ne démarrera pas et l’app ne servira à rien. Si vous êtes concerné, il faudra donc patienter ou contourner Smart App Control.
À télécharger
pour ceux qui veulent !
Source : korben.info